正規分布とは?平均・標準偏差・分散と確率の求め方を解説!(分布関数)
正規分布は、テストの得点、製品の寸法、測定誤差など、ばらつきのあるデータを理解するために広く使われる確率分布です。
グラフが左右対称の釣鐘形になることは知られていますが、平均、標準偏差、分散が何を表し、確率をどう計算するのかで迷うこともあるでしょう。
この記事では、正規分布の基本的な仕組みから、確率密度関数と分布関数の違い、標準化を使った確率の求め方までを順に解説します。
数式だけで終わらせず、具体的な数値例を交えながら、統計の問題や実務で使う際の見方も確認していきましょう。
正規分布の意味と基本的な性質
それではまず正規分布の意味と基本的な性質について解説していきます。
平均を中心とする左右対称の確率分布
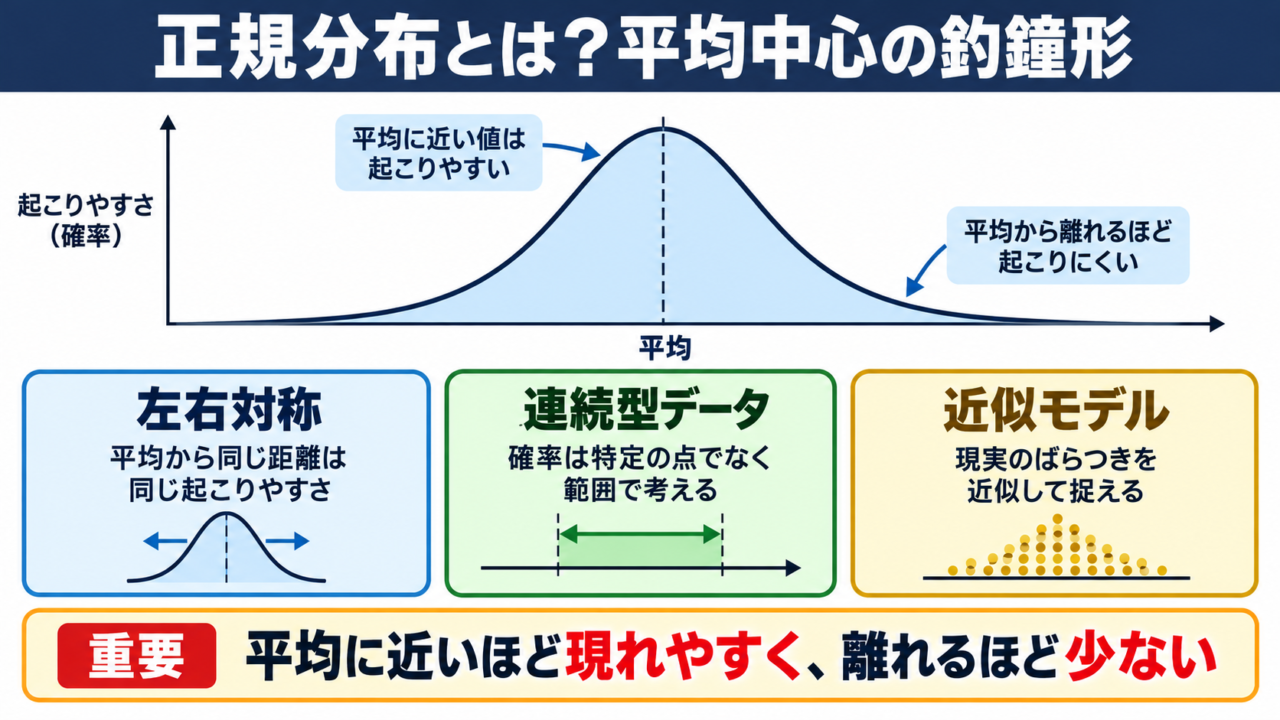
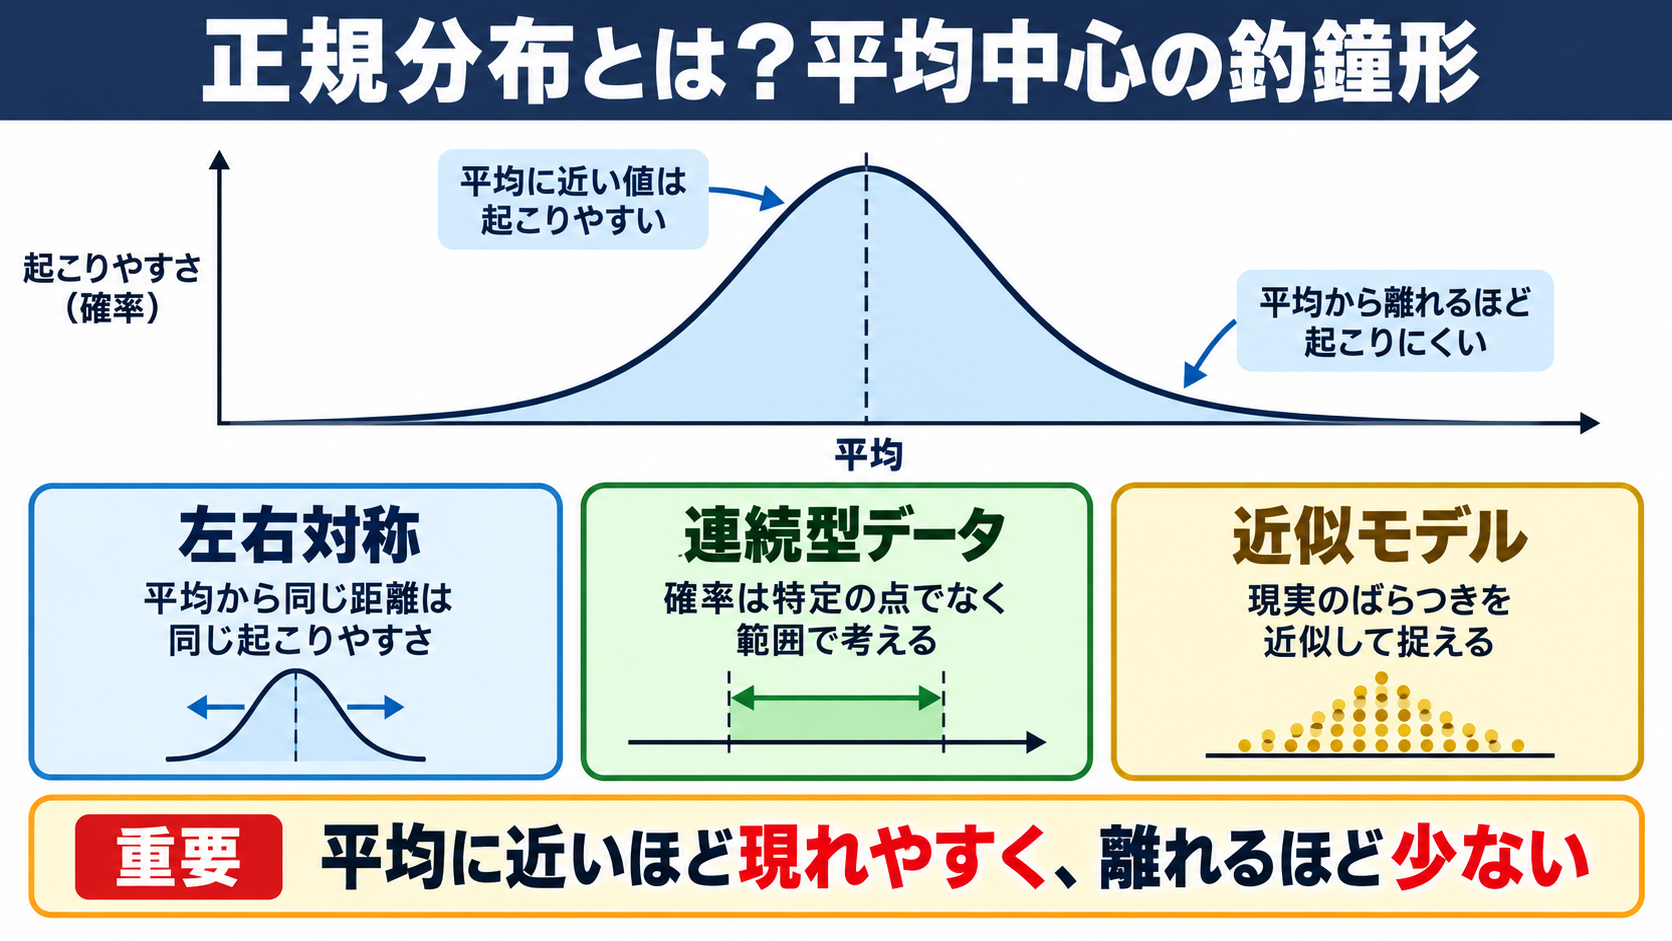
正規分布とは、平均を中心として左右対称に広がる釣鐘形の確率分布です。
確率分布とは、ある値がどの程度起こりやすいかを、数値やグラフで表したものです。
正規分布では、平均に近い値ほど現れやすく、平均から遠い値ほど現れにくくなります。
たとえば、ある学年の身長の平均が170 cmなら、170 cm前後の生徒は多く、150 cmや190 cmに近い生徒は比較的少なくなる傾向があります。
ただし、実際の身長データが必ず完全な正規分布になるわけではありません。
人数が少ない集団や、年齢、性別、競技種目などが混ざった集団では、山が複数できたり、左右の形が崩れたりすることもあります。
正規分布は、現実のデータをそのまま保証する形ではなく、ばらつきを近似して考えるための代表的なモデルです。
平均の左右で同じ距離にある値は、理想的な正規分布では同じ起こりやすさを持ちます。175 cmと165 cmは、平均170 cmから5 cm離れているため、同程度に現れやすいと考えます。
正規分布の中心は平均です。
平均からの距離が大きくなるほど、値が現れる可能性は小さくなります。
この対称性を理解すると、片側の確率が分かれば、反対側の確率も利用して求められるようになります。
連続型データと面積による確率
正規分布は、身長、時間、重さ、温度のように、理論上は小数を含む無数の値を取れる連続型のデータに用いられます。
連続型の確率分布では、特定の一点だけを取る確率は0として扱います。
たとえば、身長がちょうど170.000000 cmである確率を求めるのではなく、169 cmから171 cmまでに入る確率のように、範囲で考えることが重要です。
グラフの縦軸は確率そのものではなく、値の周辺にデータが集まりやすい度合いを表す確率密度です。
したがって、縦軸の値が0.2だからといって、その値になる確率が20%という意味にはなりません。
正規分布で範囲に入る確率は、確率密度関数のグラフと横軸で囲まれた面積で表します。
グラフ全体の面積は必ず1になり、これは全ての可能性を合わせた確率が100%であることに対応します。
平均より左側の面積と右側の面積は、それぞれ0.5です。
この性質から、平均以下である確率、または平均以上である確率は、どちらも50%と分かります。
測定値を整数に丸めて記録する場合でも、背後にある量が連続的に変化するなら、正規分布の考え方は活用できます。
ただし、合格と不合格、購入したとしないといった二択の結果には、通常は別の確率モデルを検討します。
正規分布が使われる場面と注意点
正規分布は、誤差の分析、品質管理、学力の分布、標本平均の推定など、統計学の多くの場面で基礎になります。
製造業では、ねじの直径や部品の重さが目標値の周りにどのように散らばるかを確認するために使われます。
学校のテストでは、得点そのものが正規分布に近いかを調べることで、試験の難しさや設問の偏りを考える手がかりになります。
金融や医療の分野でも用いられますが、極端な値が起きやすいデータでは、安易に正規分布と決めつけることはできません。
たとえば、商品の購入金額は少額の商品に集中しながら、一部の高額購入が大きく影響するため、右側に長い裾を持つ形になりやすいデータです。
正規分布を使う前には、ヒストグラムや箱ひげ図で、データの形と外れ値を確認することが大切です。
平均だけを見ると標準的に見えても、少数の極端な値が平均を大きく動かしている場合があります。
また、観測値が互いに強く影響し合う場合は、単純な正規分布として扱えないこともあります。
モデルは結論を自動で出す道具ではなく、データの特徴を整理して判断するための道具として使う姿勢が必要です。
平均と標準偏差と分散の役割
続いては平均と標準偏差と分散の役割を確認していきます。
平均による分布の中心位置
平均は、データの中心がどこにあるかを示す代表値です。
正規分布では平均を μ と書き、グラフの山の頂点に対応します。
データが 160、165、170、175、180 cmなら、合計は850 cmで、人数は5人なので、平均は170 cmです。
平均が180 cmの正規分布と、平均が170 cmの正規分布を比べると、形が同じでも、前者はグラフ全体が右側へ10 cm移動します。
平均は分布の位置を決めますが、データがどれくらい散らばっているかまでは示しません。
平均が同じ170 cmでも、169 cmから171 cmに集中する集団と、150 cmから190 cmまで幅広く分かれる集団では、性質が大きく異なります。
平均の計算
平均 μ = データの合計 ÷ データ数
身長が 160、165、170、175、180 cm の場合
μ = 850 cm ÷ 5 = 170 cm
μ の単位は元のデータと同じ cm です。
平均は、全ての値を使って計算するため、非常に大きい値や小さい値の影響を受けやすい特徴があります。
極端な外れ値があるときは、中央値も併せて確認すると、データの中心をより適切に判断できるでしょう。
標準偏差によるばらつきの把握
標準偏差は、データが平均からどの程度離れているかを、元のデータと同じ単位で表す値です。
正規分布では標準偏差を σ と書き、σが大きいほど山は低く横に広がり、σが小さいほど山は高く細くなります。
平均が同じでも、標準偏差が異なれば、ある範囲に収まる割合は変わります。
たとえば平均170 cm、標準偏差2 cmの集団は身長が平均付近に集まっていますが、標準偏差8 cmの集団は個人差がより大きい集団です。
標準偏差は、平均からの典型的な距離を読み取るための目安です。
正規分布では、平均から標準偏差1個分以内に入る割合は約68%です。
標準偏差2個分以内なら約95%、3個分以内なら約99.7%になります。
この割合は経験則として知られ、品質管理や異常値の確認でもよく利用されます。
ただし、標準偏差が8 cmだからといって、全員が平均から必ず8 cm離れているわけではありません。
標準偏差は個々の値の距離ではなく、集団全体の散らばりを要約した指標です。
分散と標準偏差の使い分け
分散は、平均からの差を二乗して平均した量であり、ばらつきを数値化するための基本的な指標です。
母集団の分散は σ² と表し、標準偏差 σ を二乗した値に等しくなります。
差をそのまま足すと、平均より大きい値と小さい値が打ち消し合うため、分散では差を二乗します。
二乗を使うことで、平均との差が大きい値ほど、ばらつきに強く影響する仕組みです。
一方で、分散の単位は元の単位の二乗になります。
身長の単位がcmなら分散の単位はcm²となるため、日常的な解釈では標準偏差のほうが扱いやすいことが多いでしょう。
分散と標準偏差の関係
分散 σ² = 平均した二乗偏差
標準偏差 σ = √σ²
分散が 64 cm² の場合
σ = √64 cm² = 8 cm
分散の単位は cm²、標準偏差の単位は cm です。
計算式の整理や統計モデルでは分散を使い、データの散らばりを説明するときは標準偏差を使うのが一般的です。
標本から母集団を推定する計算では、分散を求める際にデータ数ではなくデータ数から1を引いた数で割る場合もあります。
これは標本分散と不偏分散の違いであり、目的に応じて使い分ける必要があります。
確率密度関数と分布関数の仕組み
続いては確率密度関数と分布関数の仕組みを確認していきます。
確率密度関数による分布の形
正規分布の形を数式で表すものが、確率密度関数です。
平均を μ、標準偏差を σ、値を x とすると、正規分布の確率密度関数は次の式で表されます。
正規分布の確率密度関数
f(x)= 1 ÷ (σ√2π)× exp{-(x-μ)² ÷ (2σ²)}
x は観測する値で、単位は対象のデータと同じです。
μ は平均で、単位は x と同じです。
σ は標準偏差で、単位は x と同じです。
f(x)の単位は、x の単位の逆数になります。
式にある π は円周率、exp は指数関数を表します。
数式は複雑に見えますが、平均付近を高く、中心から離れるほど低くし、全体の面積を1にするための式です。
平均 μ が変われば山の位置が動き、標準偏差 σ が変われば山の幅が変化します。
確率密度関数の値は、特定の範囲にどれほど密度があるかを示すため、単独で確率と読み替えないことが重要です。
たとえば、横幅が狭い範囲でも密度が高ければ、一定の確率を持つことがあります。
逆に、密度が低い場所でも範囲を広く取れば、面積としては無視できない確率になることがあります。
分布関数による累積確率
分布関数は、ある値以下になる確率を表す関数です。
正規分布の分布関数を F(x)とすると、F(x)は X が x 以下である確率を示します。
分布関数は、左端から指定した値までの面積を積み上げた累積確率です。
たとえば、F(170)=0.5なら、170 cm以下となる確率は50%です。
平均170 cmの正規分布では、左右対称であるため、この結果になります。
F(180)=0.9なら、180 cm以下となる確率は90%であり、180 cmより高い確率は10%です。
連続型の正規分布では、値aからbまでに入る確率を、F(b)からF(a)を引いて求めます。
範囲の確率の考え方
P(a < X ≦ b)= F(b)-F(a)
左側の累積確率を引き算すると、間の面積だけを取り出せます。
分布関数は0から1の間で増加し、xが大きくなるほど小さくなることはありません。
この性質を知っていると、計算結果が負の値や1を超える値になったとき、入力や引き算の順序の誤りに気付きやすくなります。
確率密度関数と分布関数の違い
確率密度関数と分布関数は似た名前ですが、役割は異なります。
確率密度関数はグラフの高さを示し、分布関数は左から累積した面積を示します。
前者は釣鐘形になり、後者は左下から右上へ上がるS字形になります。
平均付近では確率密度関数が高く、分布関数の増え方も急になります。
一方、両端では密度が低いため、分布関数の増え方は緩やかです。
| 比較項目 | 確率密度関数 | 分布関数 |
|---|---|---|
| 表す内容 | 値の周辺の起こりやすさ | 指定値以下の累積確率 |
| 記号の例 | f(x) | F(x) |
| グラフの形 | 釣鐘形 | S字形 |
| 確率の求め方 | 範囲の面積を考える | 2つの値を引き算する |
| 主な用途 | 分布の形の確認 | 累積確率、区間確率の計算 |
確率を数値として求めたいときは、分布関数を使うと範囲の計算を整理しやすくなります。
表計算ソフトや統計ソフトでは、累積確率を返す機能が分布関数に対応していることが多いため、設定する項目を確認しましょう。
標準化を使った確率の求め方
続いては標準化を使った確率の求め方を確認していきます。
標準正規分布への変換
平均や標準偏差が異なる正規分布どうしを同じ基準で扱うために、標準化を行います。
標準化とは、元の値から平均を引き、標準偏差で割ることで、平均との差を標準偏差何個分かに変換する手順です。
変換後の値は z 得点と呼ばれ、平均0、標準偏差1の標準正規分布に従います。
標準化の式
z = (x-μ)÷ σ
x は観測値、μ は平均、σ は標準偏差です。
x、μ、σ の単位は同じです。
z は単位を持たない値です。
たとえば、平均70点、標準偏差10点の試験で80点を取った場合、z得点は1です。
これは平均より標準偏差1個分だけ高い位置にいることを表します。
別の試験で平均50点、標準偏差15点、得点65点なら、z得点も1になります。
得点の差は10点と15点で異なっていても、集団内での相対的な位置は同じと判断できます。
標準化は、単位や尺度が異なるデータを、平均との差という共通の物差しで比較する方法です。
ただし、z得点が同じでも、元のデータの意味や測定条件まで同じになるわけではありません。
片側確率と両側確率の計算
標準正規分布表や統計ソフトを使うと、z得点に対応する累積確率を調べられます。
標準正規分布で z = 1.00 の累積確率は約0.8413です。
これは、平均より標準偏差1個分上の値以下に入る確率が約84.13%であることを示します。
平均より標準偏差1個分上を超える確率は、1から0.8413を引いて約0.1587、つまり約15.87%です。
左右対称性を使えば、平均より標準偏差1個分下より小さい確率も約15.87%と分かります。
標準正規分布の代表的な範囲
平均から標準偏差1個分以内は約68%です。
平均から標準偏差2個分以内は約95%です。
平均から標準偏差3個分以内は約99.7%です。
両側の端に入る確率を求めるときは、片側の確率を2倍します。
たとえば、平均から標準偏差2個分より外側に入る確率は、約5%です。
有意水準5%を両側に分ける検定では、左右それぞれ約2.5%ずつの領域を考えることになります。
具体例による区間確率の計算
平均70点、標準偏差10点の得点が正規分布に従うと仮定し、60点から80点までに入る確率を求めます。
60点のz得点は-1、80点のz得点は1です。
標準正規分布の累積確率は、z=1で約0.8413、z=-1で約0.1587となります。
したがって、60点から80点までに入る確率は、0.8413から0.1587を引いた約0.6826です。
60点から80点までに入る確率
z(60)= (60-70)÷ 10 = -1
z(80)= (80-70)÷ 10 = 1
P(60 ≦ X ≦ 80)= 0.8413-0.1587 = 0.6826
確率は約68.26%です。
区間確率は、上限の累積確率から下限の累積確率を引くことで求めます。
端の値を含むかどうかは、連続型の正規分布では確率の値に影響しません。
ただし、実際のテスト得点のように整数だけを取るデータでは、近似の仕方によって連続補正を検討する場合があります。
問題文で正規分布に従うと明記されているか、元のデータが連続量かを確認してから計算に入りましょう。
正規分布を読むための実践的な視点
続いては正規分布を読むための実践的な視点を確認していきます。
平均と標準偏差から読む位置関係
正規分布の問題では、平均と標準偏差を先に確認すると、数値の意味をつかみやすくなります。
平均より上か下かを見れば、分布の中心に対する方向が分かります。
さらに平均との差を標準偏差で割れば、どの程度珍しい位置にあるかを判断できます。
平均100、標準偏差15の検査で130点なら、平均との差は30点で、標準偏差2個分上です。
この位置より高い側に入る確率は約2.3%なので、比較的少ない結果だと考えられます。
一方、115点は標準偏差1個分上であり、約16%程度の人がそれより高い側にいる位置です。
| z得点の範囲 | 平均からの位置 | おおよその見方 |
|---|---|---|
| 0 | 平均と同じ | 分布の中心 |
| -1から1 | 標準偏差1個分以内 | 多くの値が入る範囲 |
| -2から2 | 標準偏差2個分以内 | ほとんどの値が入る範囲 |
| 2より大きい | 平均よりかなり高い側 | 比較的まれな値 |
| -2より小さい | 平均よりかなり低い側 | 比較的まれな値 |
z得点は優劣を決める数字ではなく、集団の中での相対的な位置を表す数字です。
少人数の集団や偏りのあるデータでは、正規分布の割合をそのまま当てはめず、実際の分布も確認してください。
外れ値と正規性の確認方法
外れ値とは、ほかの値から大きく離れている観測値を指します。
正規分布を前提にする場合、平均から標準偏差3個分以上離れた値は、統計的に珍しい値として注目されることがあります。
しかし、珍しい値だからといって、すぐに入力ミスや異常値と決めることはできません。
たとえば、工場で測定した部品の寸法が極端に異なるなら、測定機器の不具合、材料の変化、工程条件の変動など、原因を調べる必要があります。
一方、売上金額の非常に大きな値は、実際に大口取引があった結果かもしれません。
正規性を確かめるには、ヒストグラムで山が一つか、左右の裾が大きく偏っていないかを見ます。
Q-Qプロットのような図を使うと、データが正規分布からどの程度離れているかを視覚的に確認できます。
| 確認項目 | 見る内容 | 注意点 |
|---|---|---|
| ヒストグラム | 山の数、左右の偏り、裾の長さ | 階級幅で見え方が変わる |
| 箱ひげ図 | 中央値、四分位範囲、外れ値 | 分布全体の細かな形は分かりにくい |
| Q-Qプロット | 点が直線付近に並ぶか | 標本数が少ないと判断しにくい |
| 平均と中央値 | 中心のずれ | 大きく異なる場合は歪みを疑う |
外れ値の処理は、削除を急ぐのではなく、発生理由を確かめてから判断することが基本です。
正規分布と確率計算のまとめ
正規分布は、平均を中心に左右対称に広がる連続型の確率分布です。
平均は分布の中心を示し、標準偏差と分散はデータのばらつきを表します。
確率密度関数ではグラフの高さを、分布関数では指定した値以下になる累積確率を扱います。
範囲に入る確率は、上限と下限の分布関数の値を引くことで求められます。
平均と標準偏差が分かれば、標準化によって異なる尺度のデータを共通のz得点で比較できます。
平均から標準偏差1個分以内には約68%、2個分以内には約95%が入るという目安も、分布を読む際に役立ちます。
ただし、現実のデータが常に正規分布に従うとは限らないため、ヒストグラムや外れ値も確認する姿勢が必要です。
まずは身近なテスト得点や測定値について、平均、標準偏差、z得点を順に計算し、分布の見方を確かめてみてください。