ベータ分布とは?確率分布の特徴と平均・分散の求め方を解説!
ベータ分布は、成功する確率や割合のように、0から1の範囲に収まる値を扱うための連続確率分布です。
コインが表になる確率、広告をクリックする割合、製品が不良品でない割合など、不確実な比率を考える場面で役立ちます。
2つのパラメータを変えるだけで山の位置や広がりを柔軟に表せるため、統計学だけでなく機械学習やベイズ推定でも広く使われています。
この記事では、ベータ分布の基本的な仕組みから、平均と分散の公式、具体的な計算例、二項分布との関係までを順に解説します。
公式だけを暗記するのではなく、数値がグラフの形にどう表れるのかを理解すると、実際のデータ分析でも使いやすくなるでしょう。
ベータ分布の定義と確率の表し方
それではまずベータ分布の基本的な定義と確率の表し方について解説していきます。
0から1までの連続確率分布
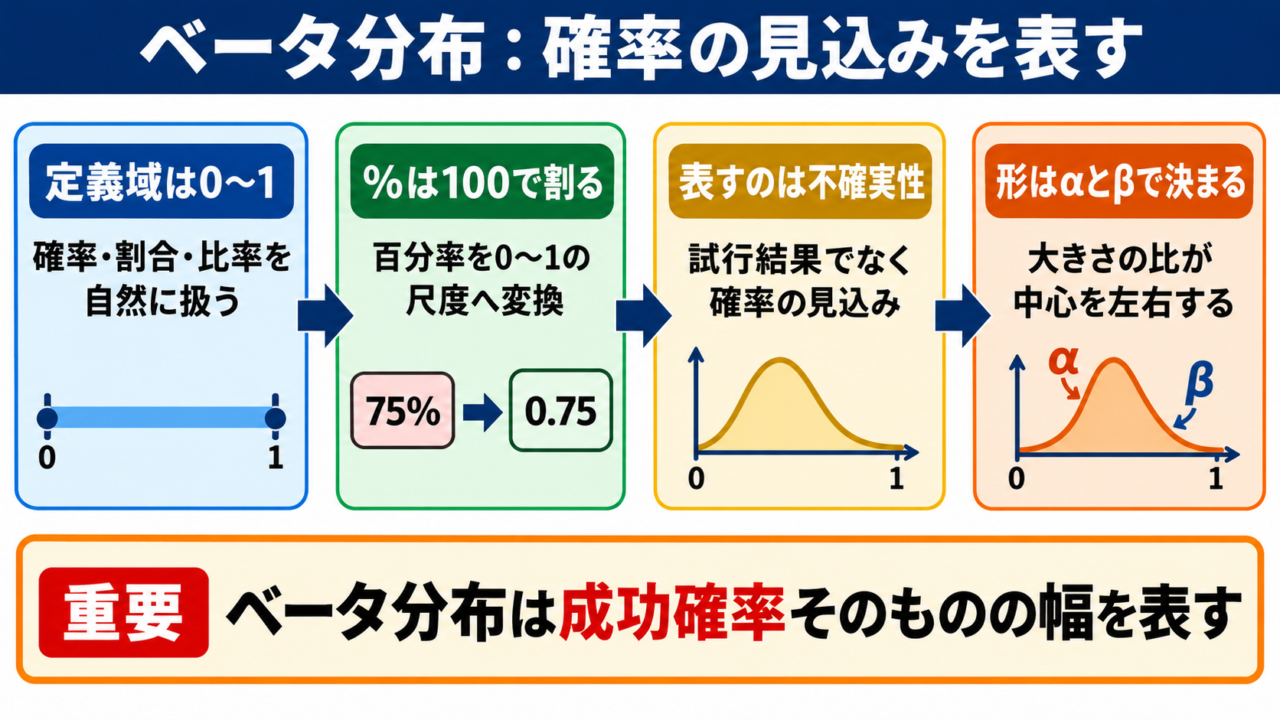
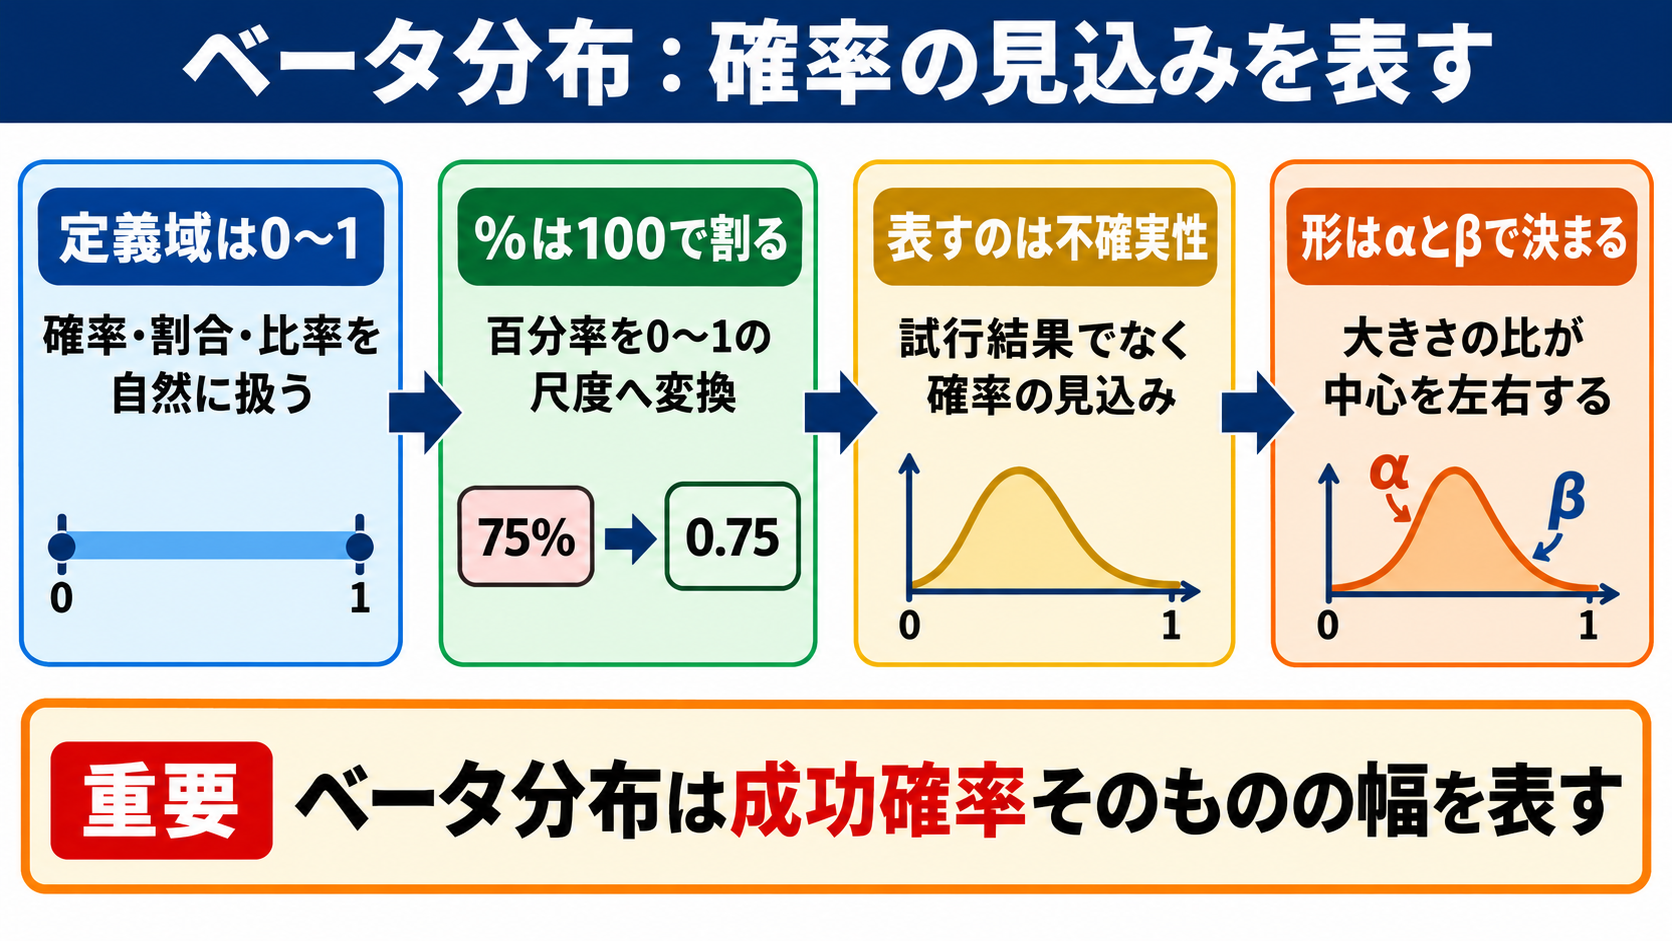
ベータ分布とは、0以上1以下の連続した値がどの程度起こりやすいかを表す確率分布です。
扱う変数は通常 x で表され、x は0から1の範囲だけを取ります。
この範囲は、確率、割合、比率、達成率のように、全体に対する一部の大きさを扱う際に自然な設定です。
たとえば、ある通販サイトで購入者がレビューを書く確率を考えると、その値は0パーセントから100パーセントの間に収まります。
百分率で表した値を100で割れば、ベータ分布が扱う0から1の尺度へ変換できます。
正規分布は負の値や1を超える値も取り得るため、確率そのものを直接表す用途では不自然になる場合があります。
一方、ベータ分布は定義域が最初から限定されているため、確率らしい値を無理なく扱える点が特徴です。
ただし、ベータ分布は個々の試行結果そのものを表す分布ではありません。
表か裏か、合格か不合格かのような1回ごとの結果には、通常はベルヌーイ分布や二項分布を用います。
ベータ分布が表すのは、その結果が生じる確率がどのあたりにありそうかという、確率への不確実性です。
ベータ分布は、結果のばらつきではなく、成功確率や割合そのものに対する見込みのばらつきを表す分布です。
観測前に持っている知識や、少ないデータから考える確率の幅を表現する場面に向いています。
2つのパラメータによる形状
ベータ分布の形は、αとβという2つの正のパラメータによって決まります。
αは成功側の重み、βは失敗側の重みとして説明されることが多く、両者の大きさの比が分布の中心を左右します。
αがβより大きいと1に近い値が起こりやすく、βがαより大きいと0に近い値が起こりやすくなります。
たとえば αが8、βが2なら、成功確率は高い側にありそうだという見方になります。
反対に αが2、βが8なら、成功確率は低い側に偏る形です。
αとβがどちらも1の場合は、0から1までのどの値も同じ程度にあり得る一様分布になります。
αとβがともに大きく、しかも近い値なら、中央付近へなだらかに集中する形になります。
一方で両方が1未満の場合は、中央が低く両端が高い形になることがあります。
これは、確率が中間程度であるよりも、ほとんど0かほとんど1のどちらかである可能性を重く見る状態です。
パラメータは分布の平均だけでなく、どれほど自信を持っているかという感覚にも関係します。
比率だけを見て判断すると、観測数の違いを見落とすため注意が必要です。
ベータ分布の確率密度関数は次の式で表されます。
f x = xのαマイナス1乗 × 1マイナスxのβマイナス1乗 ÷ B α β
xは0以上1以下の確率または割合、αとβは正の形状パラメータです。
B α βはベータ関数と呼ばれ、全体の面積が1になるように調整します。
確率密度と面積の読み取り方
ベータ分布のグラフの縦軸は、特定の確率が起こる確率そのものではなく、確率密度です。
たとえば横軸の0.7付近でグラフが高くても、成功確率がちょうど0.7になる確率が高いという意味ではありません。
連続分布では、ちょうど1つの値を取る確率は0として扱われます。
意味を持つのは、0.65から0.75のような範囲を指定したときの、曲線下の面積です。
確率密度の高さは起こりやすさの濃さを示し、区間の面積が実際の確率を示します。
たとえば、問い合わせに返信する確率が0.6から0.8の間にある見込みを知りたいなら、その区間の面積を計算します。
グラフの頂点だけで結論を出すと、分布の幅や不確実性を十分に読めません。
同じ平均が0.7でも、細く高い山なら見込みは比較的確かであり、幅広い山なら判断の余地が大きい状態です。
実務では、平均だけでなく、確率がどの範囲に入るかを確認することが大切になります。
ベイズ推定では、この分布から信用区間に近い範囲を求め、意思決定の材料にすることもあります。
ただし、密度の値が1を超える場合があっても誤りではありません。
面積が1に整えられていればよく、縦軸の値だけを通常の確率と混同しないことがポイントです。
平均と分散の公式
続いてはベータ分布の平均と分散の公式を確認していきます。
平均を求める基本式
ベータ分布の平均は、αをαとβの合計で割ることで求められます。
平均は α ÷ α足すβ であり、成功側の重みが全体に占める割合として理解できます。
αとβの比だけが同じなら、平均も同じ値になります。
たとえば αが2、βが3の場合も、αが20、βが30の場合も、平均は0.4です。
しかし、この2つの分布は同じ形ではありません。
後者はパラメータの合計が大きいため、0.4付近により集中しやすくなります。
平均は分布の重心に近い値であり、最も高い位置を示す最頻値とは一致しないことがあります。特にパラメータが小さい場合や、分布が左右へ大きく偏る場合には違いが目立ちます。
成功回数と失敗回数をもとに更新するベイズ推定では、αとβを疑似的な観測回数のように捉える説明も用いられます。
ただし、初期設定の意味は分析の方法によって異なるため、単純な実測回数とみなす前に前提を確認しましょう。
平均の公式は次のとおりです。
平均 = α ÷ α足すβ
αとβはどちらも単位を持たない正の数です。
αが6、βが4なら、平均 = 6 ÷ 10 = 0.6 となります。
この値は、成功確率の代表値が60パーセント付近であることを示します。
分散を求める基本式
分散は、成功確率が平均の周囲にどの程度広がっているかを数値で表す指標です。
ベータ分布の分散は、αとβの積を、αとβの合計の2乗とその合計に1を加えた値で割って求めます。
分散は αβ ÷ α足すβの2乗 × α足すβ足す1 で求められます。分散が小さいほど、分布は平均の近くへ集まりやすくなります。
分散が大きいほど、どの確率がもっともらしいかという見込みが広く、判断の不確実性も大きくなります。
ここで重要なのは、平均が同じでも分散は異なり得ることです。
αが2、βが3の分布と、αが20、βが30の分布は、いずれも平均0.4です。
しかし後者はパラメータの合計が大きいため、観測や事前知識が多い状態を反映し、分散は小さくなります。
分散の単位は、確率が単位を持たない値であるため、基本的に単位なしです。標準偏差を知りたい場合は、分散の平方根を取ります。
数値だけでは実感しにくいときは、平均が同じ複数のベータ分布をグラフで比較すると、広がりの差を理解しやすくなります。
具体例による平均と分散の計算
ここでは αが4、βが6のベータ分布を例に、平均と分散を順番に計算します。
この設定は、成功側より失敗側の重みが少し大きく、成功確率が半分よりやや低いと見る状態です。
平均は4を4と6の合計で割るため、0.4になります。
分散では、まず αβ を計算すると4掛ける6で24です。
次に αとβの合計は10であり、その2乗は100、さらに合計に1を加えると11になります。
したがって分母は100掛ける11で1100となり、分散は24 ÷ 1100です。
計算結果は約0.0218で、標準偏差は約0.148となります。
平均だけを見ると0.4ですが、実際にはその周辺に一定の幅があることが分かります。
データが少ない段階でこの分布を使う場合は、平均を固定的な真値と捉えず、幅を持った推定として読む姿勢が必要です。
計算機や表計算ソフトを使う際も、分散と標準偏差を取り違えないようにしましょう。
α = 4、β = 6の計算例です。
平均 = 4 ÷ 4足す6 = 0.4
分散 = 4掛ける6 ÷ 4足す6の2乗 × 4足す6足す1
分散 = 24 ÷ 1100 = 約0.0218
標準偏差 = 約0.0218の平方根 = 約0.148
パラメータとグラフ形状の関係
続いてはパラメータとグラフ形状の関係を確認していきます。
αとβの大小による偏り
αとβのどちらが大きいかを見ると、分布が0側と1側のどちらへ寄るかをすばやく判断できます。
αがβより大きい場合は、成功確率が高い領域に多くの重みが置かれます。
反対にβが大きい場合は、低い成功確率がよりもっともらしい形です。
たとえば、新商品の購入率について、過去の類似商品が好調だったという情報があれば、αを相対的に大きく置く考え方があります。
一方で、初めての施策で反応が未知なら、どちらかへ強く偏らせない設定が検討できます。
αとβの差は分布の向きを示し、αとβの合計は分布の集中度に影響します。
この2つの役割を分けて考えると、パラメータの意味を混同しにくくなります。
ただし、αが大きいからといって、実際の成功率が必ず高いと断定できるわけではありません。
あくまで、設定された情報や観測結果にもとづく分布上の見込みです。
データを追加すると、成功数と失敗数に応じてαとβが更新され、グラフの偏りも変化します。
その変化を追うことで、新しい情報が予測へ与えた影響を視覚的に捉えられます。
パラメータ合計と確信の強さ
αとβの合計が大きくなるほど、一般には分布は平均の近くへ集まり、分散は小さくなります。
これは、成功側と失敗側の比率が同じでも、より多くの情報を反映している状態に対応します。
たとえば αが1、βが1は、どの成功確率にも偏りを持たない一様な形です。
αが10、βが10なら平均は同じ0.5ですが、0.5付近がより強く支持されます。
平均が同じでも、αとβの合計が異なれば、推定の確かさは同じではありません。
この点は、少人数のアンケート結果と大規模調査の割合を比較すると理解しやすいでしょう。
回答者10人中5人が賛成した結果と、回答者1000人中500人が賛成した結果は、割合は同じでも信頼の置き方が異なります。
ベータ分布は、その差を分布の広さとして表せます。
ただし、データ数が多ければ常に正しいとは限りません。
偏った対象だけを集めた場合や、測定方法に問題がある場合には、パラメータを大きくしても偏りそのものは解消されません。
分布の計算と同時に、元データの集め方も確認する必要があります。
代表的な形状の比較表
パラメータの組み合わせごとに、ベータ分布の形状には分かりやすい傾向があります。
次の表では、代表的な組み合わせと、グラフを読む際の着眼点をまとめます。
| αとβの関係 | 平均の位置 | 分布の主な形 | 読み取り方 |
|---|---|---|---|
| α = 1、β = 1 | 0.5 | 一様 | どの確率にも特別な偏りがない状態 |
| α > β | 0.5より大きい | 1側へ偏る | 高い成功確率を比較的支持する状態 |
| α < β | 0.5より小さい | 0側へ偏る | 低い成功確率を比較的支持する状態 |
| α = β > 1 | 0.5 | 中央が高い | 中間の確率を支持する状態 |
| α = β < 1 | 0.5 | 両端が高い | ほぼ0かほぼ1を支持する状態 |
表の形状は典型例であり、実際のグラフの鋭さはαとβの具体的な大きさで変わります。
中央が高い形であっても、パラメータが小さければ山は広く、強い確信を意味するとは限りません。
反対に、左右へ偏った形でも、合計が大きければ特定の範囲へかなり集中する場合があります。
グラフを見るときは、山の位置だけでなく、横方向の広がりと端の高さも合わせて確認しましょう。
二項分布とベイズ推定の関係
続いては二項分布とベイズ推定の関係を確認していきます。
二項分布との役割の違い
二項分布とベータ分布は、成功と失敗を扱うという共通点がありますが、表している対象が異なります。
二項分布は、成功確率が決まっていると仮定したうえで、複数回の試行で何回成功するかを表します。
ベータ分布は、その成功確率自体がどの値でありそうかを表します。
二項分布は結果の回数、ベータ分布は成功確率への不確実性を扱う点が大きな違いです。
たとえば、10回メールを送ったときに何人が返信するかを考えるなら、二項分布が適しています。
一方で、そもそも返信率が何パーセント程度なのか分からない場合、その返信率の見込みを表すのにベータ分布を使えます。
この関係により、確率が未知の二項試行を段階的に分析できます。
事前にはベータ分布で返信率への考えを置き、実際の返信件数を観測した後に分布を更新します。
観測後の分布は、事後分布と呼ばれます。
ただし、各試行が独立であり、成功確率が試行ごとに大きく変わらないという仮定には注意が必要です。
曜日、配信時間、顧客層によって反応率が変わるなら、1つの確率だけでまとめると実態を見失うことがあります。
| 比較項目 | ベータ分布 | 二項分布 |
|---|---|---|
| 対象 | 成功確率や割合 | 成功回数 |
| 値の範囲 | 0から1の連続値 | 0回から試行回数までの整数 |
| 主なパラメータ | αとβ | 試行回数と成功確率 |
| 利用場面 | 確率の推定と更新 | 結果の回数の予測 |
| 代表的な用途 | ベイズ推定の事前分布 | 成功数の確率計算 |
観測結果によるパラメータ更新
ベータ分布がベイズ推定でよく使われる理由は、二項分布のデータを観測した後も、同じベータ分布の形で更新できるためです。
事前分布を Beta α β とし、成功がs回、失敗がf回観測されたとします。
このとき、更新後の事後分布は Beta α足すs、β足すf となります。
成功回数をαへ、失敗回数をβへ加えるだけで、観測後の成功確率の分布を求められます。
たとえば事前分布が Beta 2 2 で、10回中7回成功した場合、事後分布は Beta 9 5 です。
事前の平均は0.5ですが、観測結果を反映した事後平均は9 ÷ 14で約0.643になります。
成功率70パーセントという実測値に近づきつつも、事前の情報も一部残る形です。
観測数が増えるほど、事前分布が事後分布に与える相対的な影響は小さくなります。
最初の設定が極端すぎると、少ないデータでは結論を大きく左右するため、事前分布の選び方は明示することが重要です。
根拠が乏しい場合には、Beta 1 1のような中立的な設定を出発点にする考え方もあります。
更新式は、事前分布 Beta α β に対し、成功s回と失敗f回を観測すると Beta α足すs、β足すf になります。
この計算が成り立つのは、成功と失敗を二項分布で扱えること、各試行の成功確率が共通であることを前提とします。
事前分布を設定する際の注意点
事前分布は、データを見る前に持っている知識や仮定を数式で表したものです。
過去の同種施策、十分に信頼できる調査、専門家の知見がある場合には、それらを事前分布へ反映できます。
ただし、都合のよい結論へ近づけるためにパラメータを選ぶと、分析の公平性が損なわれます。
たとえば成功率が高いと信じたいからといって、根拠なくαだけを大きくする設定は避けるべきです。
事前分布は予測の出発点であり、希望や印象を数値化するための道具ではありません。
分析結果を共有するときは、なぜそのαとβを選んだのか、どのデータや判断を根拠としたのかを記録するとよいでしょう。
別の合理的な事前分布でも結果を計算し、結論が大きく変わらないかを確認する方法もあります。
これは感度分析と呼ばれ、少ないデータでの判断を慎重に行う際に役立ちます。
また、成功の定義が曖昧だと、どれだけ正確に分布を計算しても解釈がぶれます。
購入完了を成功とするのか、カート追加を成功とするのかを、分析前に明確に決めておくことが大切です。
数式の正しさと、現場での指標設計は切り離せない関係にあります。
実務での活用場面と読み方
続いては実務での活用場面と読み方を確認していきます。
割合データの推定と比較
ベータ分布は、観測数が少ない割合データを扱う場面で特に有用です。
新しい広告のクリック率、少数のレビューから得た満足率、試作品の合格率などは、初期段階では値が大きく揺れます。
単純に成功回数を試行回数で割るだけでは、その割合がどれほど不確かかを十分に表せません。
ベータ分布を使えば、代表値と広がりを同時に把握できます。
たとえば10件中8件で好反応があった場合、80パーセントという数値だけで大成功と判断するのは早いかもしれません。
1000件中800件の場合と比べると、前者は偶然の影響を受けやすいからです。
割合を比較するときは、比率の高さだけでなく、分布の広がりと観測数を合わせて見ることが重要です。
複数案の比較では、それぞれのベータ分布から値を取り出して、どちらが高くなる確率が大きいかを調べる方法もあります。
平均が少し高い案でも、分布が広く重なっていれば、優劣を断定しにくいケースがあります。
そのため、平均差だけを見出しにして施策を決めるより、不確実性を含めた判断が実務的です。
集計の単位や対象期間をそろえたうえで比較することも忘れないようにしましょう。
活用例と確認項目の一覧
ベータ分布は、確率や割合として定義できる対象なら、多様な分野で活用できます。
ただし、数式を当てはめる前に、成功と失敗の定義、試行の独立性、対象の均質性を確認する必要があります。
| 活用場面 | 推定する割合 | 成功の例 | 確認したい点 |
|---|---|---|---|
| 広告運用 | クリック率 | 広告がクリックされた | 媒体や配信対象の違い |
| 品質管理 | 合格率 | 検査を通過した | 製造条件の変化 |
| メール施策 | 返信率 | 期限内に返信された | 送信時刻や顧客層 |
| 顧客調査 | 満足率 | 満足と回答した | 質問文と回答者の偏り |
| 医療研究 | 反応率 | 所定の反応が得られた | 群の条件と評価基準 |
表にあるように、同じ成功率でも対象集団が異なれば、1つのベータ分布へまとめることは適切でない場合があります。
たとえば新規顧客と既存顧客の反応率を混ぜると、どちらの傾向も見えにくくなるでしょう。
条件ごとに分けて分布を持たせると、改善すべき対象を探しやすくなります。
集計前に、何を比較したいのかを決めてからデータを区分することが、解釈しやすい分析につながります。
ベータ分布を実務で使う際は、平均の順位だけで決めず、分布の重なり、観測数、成功の定義を一緒に確認します。
数値の差が小さい場合は、追加データを集める価値があるかも検討しましょう。
ベータ分布の特徴と平均分散のまとめ
ベータ分布は、0から1の範囲にある成功確率や割合の不確実性を表すための連続確率分布です。
αとβの大小は分布が0側と1側のどちらへ偏るかを示し、両者の合計は分布の集中度に影響します。
平均は α ÷ α足すβ で求められ、分散は αβ ÷ α足すβの2乗 × α足すβ足す1 で求められます。
同じ平均でもパラメータの合計が異なれば、確率への確信の強さや分布の広がりは変わります。
二項分布が成功回数を扱うのに対し、ベータ分布は成功確率そのものを扱う点も重要です。
成功回数と失敗回数を観測した後は、それぞれをαとβへ加えることで、ベイズ推定として分布を更新できます。
広告、品質管理、アンケートなどで割合を読むときは、単純な比率だけでなく、観測数と分布の幅にも目を向けましょう。
まずは身近な成功率を1つ選び、αとβを置いて平均と分散を計算してみると、ベータ分布への理解が深まります。