LRU方式とは?キャッシュ置換アルゴリズムの仕組みを解説!
パソコンやスマートフォン、Webサービスでは、処理を速くするためにキャッシュが幅広く利用されています。
ただし、キャッシュに保存できる容量には限りがあるため、新しいデータを入れる際には古いデータの一部を取り除かなければなりません。
このとき、どのデータを捨てるかを決める考え方がキャッシュ置換アルゴリズムです。
LRU方式は代表的なキャッシュ置換アルゴリズムであり、ブラウザ、データベース、OS、CDNなど多くの仕組みで考え方が使われています。
この記事では、LRU方式の基本、動作例、実装時の注意点、ほかの方式との違いを順番に解説します。
LRU方式の意味と基本原理
それではまずLRU方式の意味と基本原理について解説していきます。
最近使われていないデータを捨てる仕組み
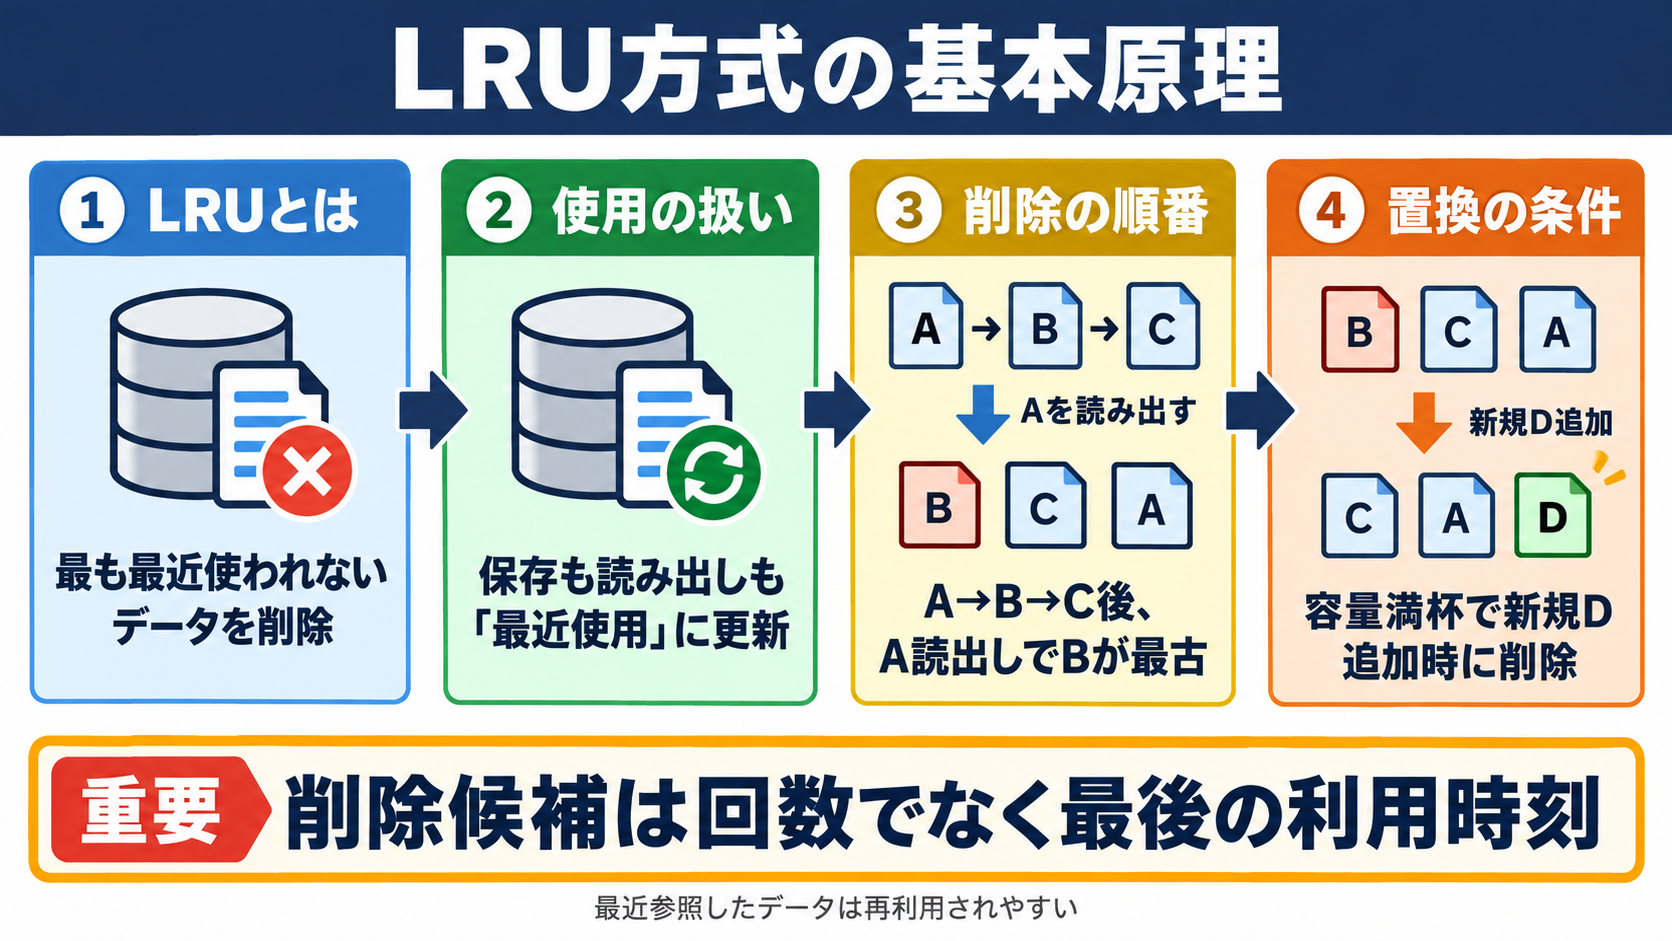
LRU方式は、最後に使われた時点から最も長く時間がたっているデータを優先してキャッシュから削除する方式です。
LRUはLeast Recently Usedの頭文字で、日本語では最も最近使われていないものという意味になります。
ここでいう使用とは、データを新しく保存することだけではありません。
すでに保存されているデータを読み出した場合も、そのデータは最近使われたものとして扱われます。
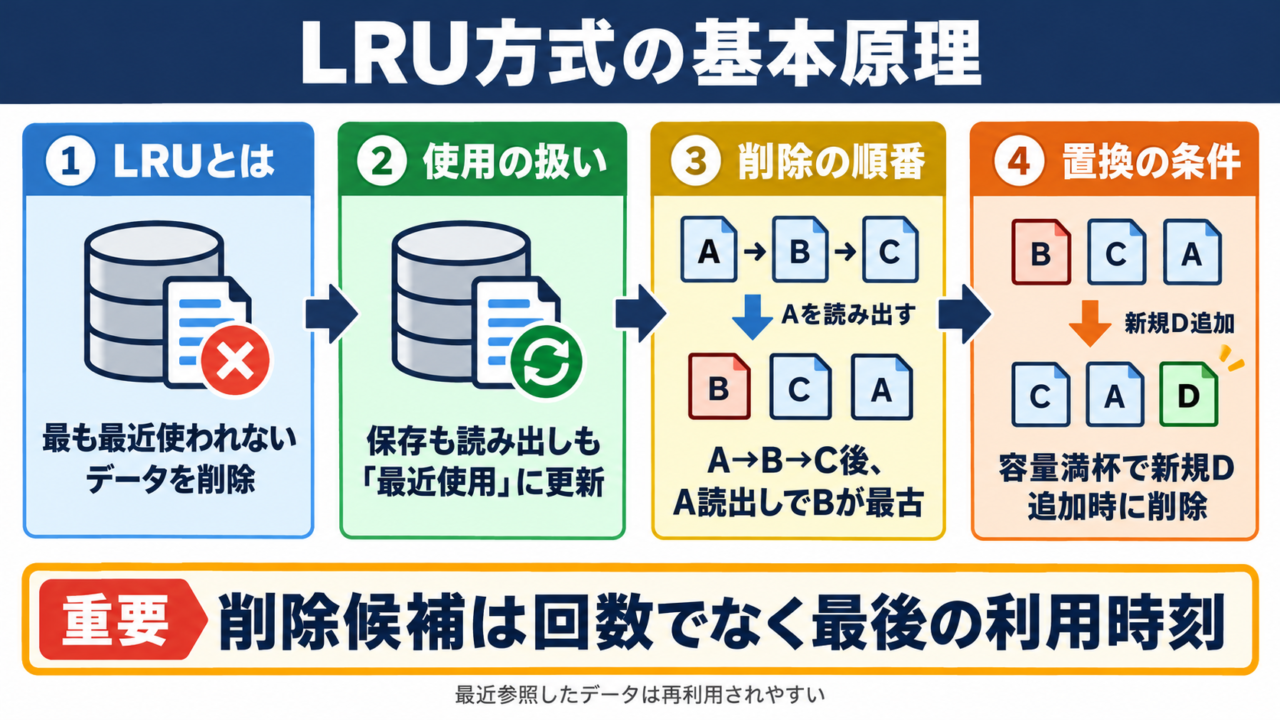
たとえば、キャッシュにA、B、Cの3件があり、利用順がA、B、Cだったとします。次にAを読み出すと、Aは最も新しく使われたデータになります。
この状態で新しいDを入れる必要が生じた場合、最も長く使われていないBが削除対象です。
LRU方式の前提には、最近参照されたデータは近い将来にも再び参照されやすいという局所性の考え方があります。
ニュースサイトで同じ記事を何度も開く、業務システムで同じ顧客情報を続けて確認するといった利用状況が身近な例でしょう。
一方で、一度だけ大量のデータを順番に読む処理では、最近使ったからといって再利用されるとは限りません。
LRU方式は利用頻度ではなく、最後に利用されたタイミングに注目する仕組みです。
何回使ったかではなく、いつ最後に使ったかで削除候補を決めます。
この違いを理解しておくと、後で紹介するLFU方式などとの使い分けも考えやすくなります。
キャッシュ容量と置換が起こる条件
LRU方式は、キャッシュが空いている間は特別な削除を行いません。
置換が必要になるのは、キャッシュが容量の上限に達した状態で、未保存のデータを追加するときです。
たとえば容量が3件のキャッシュにA、B、Cが保存されているなら、Dを追加する前に1件を削除する必要があります。
このとき各データの利用順を追跡し、最も古い利用履歴を持つデータを選びます。
キャッシュ容量が3件の場合の利用順の例
Aを保存する
Bを保存する
Cを保存する
Aを読み出す
Dを保存する
削除対象はBです。
Aは最初に保存されたデータですが、途中で読み出されているため、削除順位は新しくなります。
Cは保存後に使われていないため、Aより古い扱いです。
このように、保存時刻と最終利用時刻は別物として考える必要があります。
LRU方式ではデータを参照するだけでも、削除されにくい位置へ更新される点が重要です。
単純に登録順だけで削除するFIFO方式とは、この部分に大きな違いがあります。
キャッシュの容量はメモリ使用量、ファイル数、キー数、ストレージ容量などで設定されることがあります。
実際のシステムでは、件数ではなくバイト数が上限になるケースもあるため、データサイズも合わせて設計することが大切です。
時間的局所性とキャッシュヒット率
LRU方式が効果を発揮しやすい理由は、時間的局所性という性質と相性がよいためです。
時間的局所性とは、あるデータが使われた直後には、同じデータが再び使われやすいという傾向を指します。
Webアプリケーションでは、ログイン中の利用者が同じ画面を再表示したり、一覧画面から同じ商品情報へ戻ったりすることがあります。
このような場面では、最近使われたデータを残すLRU方式がキャッシュヒットにつながりやすくなります。
キャッシュヒットとは、必要なデータをキャッシュから取得できる状態です。
反対に、キャッシュ内に目的のデータがなく、データベースや外部APIなどへ取りに行く状態をキャッシュミスと呼びます。
キャッシュヒット率が高まるほど、処理時間、通信回数、元データへの負荷を抑えやすくなります。
ただし、ヒット率は置換方式だけで決まるものではありません。
キャッシュ容量、データの更新頻度、有効期限、アクセスの偏りも結果に影響します。
同じ商品を何度も見る通販サイトと、毎回異なる画像を一度だけ読む処理では、適した設定が異なるでしょう。
LRU方式を選ぶ際は、実際のアクセスログを確認し、再利用されるデータの特徴を把握することが欠かせません。
LRU方式の動作手順とデータ管理
続いてはLRU方式の動作手順とデータ管理を確認していきます。
アクセス順による削除対象の決定
LRU方式では、各データを最後に利用した順番で並べて管理します。
一般に、最も新しく使われたデータを先頭、最も長く使われていないデータを末尾に置く考え方が採用されます。
容量3件のキャッシュにA、B、Cが順番に入ると、利用順は新しい側からC、B、Aになります。
ここでAを読み出すと、Aは先頭へ移動し、順番はA、C、Bへ変わります。
次にDを保存するなら、末尾にあるBが削除されます。
容量3件での順序変化
Aを保存後 A
Bを保存後 B、A
Cを保存後 C、B、A
Aを参照後 A、C、B
Dを保存後 D、A、C
Bが削除されます。
この並び替えは、キャッシュに存在するデータを読み出すたびに必要になります。
つまりLRU方式は、キャッシュヒット時にも利用履歴を更新する処理が発生します。
単に値を取得するだけの仕組みと比べると、管理のための処理が少し増える点には注意が必要です。
削除候補は常に末尾へ集めておくと、容量超過時に候補をすぐ取り出せます。
この性質を生かすため、実装ではデータ検索と順序更新を効率よく行える構造が選ばれます。
ハッシュテーブルと双方向連結リストの組み合わせ
LRUキャッシュの典型的な実装では、ハッシュテーブルと双方向連結リストを組み合わせます。
ハッシュテーブルは、キーを使って目的のデータをすばやく探すために使われます。
双方向連結リストは、データの新旧順を並べ替えるために使われます。
ハッシュテーブルだけでは、最も古いデータを見つけるために全件を調べる必要が生じる場合があります。
一方、連結リストだけでは、指定したキーのデータを探すのに時間がかかります。
ハッシュテーブルでキーからノードを見つけ、双方向連結リストでノードを先頭へ移動する構成が、LRU実装の基本です。
この組み合わせにより、検索、更新、削除を平均して短時間で行いやすくなります。
双方向連結リストでは、各ノードが前後のノードへの参照を持ちます。
そのため、途中にあるノードを取り外して先頭へつなぎ直す操作を行いやすい特徴があります。
末尾のノードもすぐに分かるため、容量を超えたときの削除対象を取得しやすいでしょう。
ただし、ポインタや参照のつなぎ替えを誤ると、データの重複、欠落、循環参照につながるおそれがあります。
実装後は、同じキーの更新、先頭要素の再参照、容量1件の状態、空キャッシュへの追加などをテストすることが重要です。
計算量とメモリ使用量の考え方
LRU方式の性能を考えるときは、検索、追加、参照時の更新、削除という4つの操作を分けて確認します。
ハッシュテーブルと双方向連結リストを適切に使う実装では、これらの操作を平均してO 1で実行できます。
O 1は、保存データ数が増えても、1回の操作に必要な手順数が大きく増えにくいことを表す記法です。
ただし、ハッシュ関数の偏りや再ハッシュなどの条件によって、常に完全に一定時間になるわけではありません。
典型的なLRUキャッシュの操作コスト
キー検索 平均O 1
既存データの先頭移動 O 1
新規データの追加 平均O 1
最古データの削除 O 1
別途、キー、値、連結リストの参照を保存するメモリが必要です。
配列だけで順序を管理すると、途中のデータを先頭へ移す際に多くの要素をずらす必要があります。
容量が小さい場合には単純な配列実装でも問題にならないことがありますが、大量アクセスでは負荷が目立つ可能性があります。
処理速度だけでなく、データ本体と管理情報を合わせたメモリ使用量で容量を決めることが大切です。
値が画像、HTML、検索結果のように大きい場合、キー数だけを基準にすると想定よりメモリを消費することがあります。
キャッシュの上限をバイト単位で管理する場合は、データごとのサイズ計測と削除処理を組み合わせる設計が必要です。
LRU方式と代表的な置換方式の比較
続いては代表的なキャッシュ置換方式との違いを確認していきます。
FIFO方式とLFU方式との違い
LRU方式を理解するには、FIFO方式とLFU方式の基準を比較すると分かりやすくなります。
FIFO方式はFirst In First Outの略で、最初に入ったデータから順番に削除する方式です。
FIFO方式では、その後に何度利用されたかを考慮しません。
LFU方式はLeast Frequently Usedの略で、利用回数が最も少ないデータを削除対象にする方式です。
| 方式 | 削除の基準 | 参照時の扱い | 向きやすい状況 |
|---|---|---|---|
| LRU | 最後に使われた時点が最も古い | 利用順を最新へ更新する | 直近の再利用が多いアクセス |
| FIFO | 保存時刻が最も古い | 順序を通常は更新しない | 単純な管理を優先する場面 |
| LFU | 利用回数が最も少ない | 回数を増やして記録する | 長期間人気が続くデータ |
LRU方式では、昨日100回使われたとしても、今日まったく使われなければ削除候補へ近づきます。
LFU方式では、過去の利用回数が多いデータが長く残りやすい傾向があります。
たとえば季節限定の特集ページが以前は人気でも、終了後にアクセスされなくなった場合、LFU方式では古い人気の影響が残ることがあります。
最近の関心の変化を反映しやすい点が、LRU方式の大きな特徴です。
一方で、アクセスが一定周期で繰り返され、間隔が長いデータはLRU方式で消えてしまう場合があります。
アクセス特性に応じて、方式単体ではなく有効期限や優先度を組み合わせることも検討しましょう。
ランダム方式とMRU方式との使い分け
キャッシュ置換には、ランダム方式やMRU方式という選択肢もあります。
ランダム方式は、削除対象を規則的に選ばず、候補の中からランダムに削除する方式です。
実装を単純にできる場合がありますが、アクセスの傾向を削除判断へ生かしにくい特徴があります。
MRU方式はMost Recently Usedの略で、最も最近使ったデータを削除する考え方です。
一見するとLRU方式と正反対ですが、順番に一度ずつ読む処理では有効になることがあります。
| 方式 | 削除対象 | 得意なアクセス傾向 | 注意点 |
|---|---|---|---|
| LRU | 最も長く使われていないデータ | 同じデータを短期間に再利用する | 連続一回読みで効率が下がる場合がある |
| MRU | 最も最近使われたデータ | 一度読んだ順に進む処理 | 一般的なWeb利用では直感に反しやすい |
| ランダム | 無作為に選ばれたデータ | 管理処理を軽くしたい場合 | ヒット率が安定しにくい |
データ分析で巨大なファイルを先頭から末尾まで一度だけ読む場合、直前に使ったデータが次に必要になる可能性は低いかもしれません。
反対に、画面遷移を行き来するWebアプリでは、直前の画面や関連情報が再び必要になることがあります。
このため、一般的なユーザー操作を対象にするキャッシュではLRU方式が採用候補になりやすいでしょう。
ただし、方式名だけで判断せず、実測したヒット率、応答時間、メモリ使用量を比べることが重要です。
LRU方式の活用場面と設計上の注意点
続いてはLRU方式を活用する場面と設計時の注意点を確認していきます。
ブラウザとWebアプリケーションでの利用
Webアプリケーションでは、同じ利用者が短時間に似た情報へアクセスすることが少なくありません。
商品一覧から詳細画面を開き、一覧へ戻り、別の商品を確認する流れは代表例です。
このとき、商品情報、検索結果、テンプレートの描画結果などをキャッシュしておくと、データベースへの問い合わせを減らせます。
LRU方式を使えば、利用者が直近で見た情報を残しやすくなります。
| 活用場所 | キャッシュする例 | LRU方式が役立つ理由 |
|---|---|---|
| ブラウザ | 画像、CSS、JavaScript | 閲覧中のページで同じ資産を再利用しやすい |
| Webサーバー | HTML断片、設定情報 | 短時間に繰り返される要求へ対応しやすい |
| APIクライアント | 取得結果、認証関連情報 | 同一条件の問い合わせを減らせる |
| データベース | ページ、インデックス | 頻繁に参照される領域を保持しやすい |
Webでキャッシュするデータは、速さだけでなく最新性と権限管理も考慮する必要があります。
価格、在庫、権限、個人情報のように変化や機密性が高いデータは、古い内容をそのまま返すと問題になるおそれがあります。
利用者ごとに内容が異なるページを共有キャッシュへ保存する場合は、キャッシュキーの設計も慎重に行いましょう。
同じURLでもログイン状態によって内容が変わるなら、単純なURLだけをキーにする設計は危険です。
キャッシュスタンピードと有効期限の管理
LRU方式は容量超過時の削除ルールであり、データがいつ古くなるかを決める有効期限とは役割が異なります。
有効期限がないまま長く保存すると、最近使われている古いデータが残り続ける可能性があります。
そのため、実務ではLRU方式とTTLを組み合わせる設計がよく使われます。
TTLはTime To Liveの略で、キャッシュを有効とみなす時間を表します。
たとえば為替レートを5分間、商品カテゴリを1時間、静的な設定情報を1日保存するといった設定が考えられます。
LRU方式は容量を守るための仕組みであり、TTLは情報の鮮度を守るための仕組みです。
両方を設定すると、容量不足と古い情報の残留を別々に制御できます。
また、人気データの有効期限が一斉に切れると、多数の要求が同時に元データへ集中することがあります。
この現象はキャッシュスタンピードと呼ばれます。
対策として、有効期限にばらつきを持たせる、最初の1件だけ更新処理を行う、古い値を一時的に返すといった方法があります。
LRU方式を導入しても、期限切れ時の負荷集中まで自動的に解決されるわけではありません。
キャッシュの削除履歴、ヒット率、データベース負荷を監視し、実際のアクセス増加時に問題が起きないか確認しましょう。
LRU方式の仕組みと選び方のまとめ
LRU方式は、最も長く使われていないデータを削除し、最近利用されたデータを残しやすくするキャッシュ置換アルゴリズムです。
最後に使われた時刻を基準にするため、短い間隔で同じ情報を再利用するアクセスと相性がよい特徴があります。
実装では、ハッシュテーブルと双方向連結リストを組み合わせると、検索、順序更新、削除を効率よく処理できます。
FIFO方式は保存順、LFU方式は利用回数を基準にするため、LRU方式とは削除判断の考え方が異なります。
Webアプリケーション、ブラウザ、データベースでは、直近に参照されたデータを保持する目的で活用しやすいでしょう。
一方で、連続的に一度しか読まれないデータや、長い周期で再利用されるデータでは、十分な効果が出ない場合があります。
容量設定だけでなく、TTL、データ更新、アクセス権、負荷集中への対策も合わせて検討することが大切です。
まずは対象システムのアクセス傾向を確認し、ヒット率と応答時間を測りながらLRU方式の設定を調整してみてください。