文字化けとは?原因・発生する仕組みと文字コードの関係を解説!
パソコンやスマートフォンでメール、Webサイト、PDFなどを開いたとき、意味の通らない記号や漢字が表示されることがあります。
この現象は文字化けと呼ばれ、文字そのものが壊れたように見えても、元のデータが残っている場合は復元できることがあります。
文字化けは、主に文字コードの設定や解釈が送信側と受信側で一致しないことで起こります。
この記事では、文字化けの意味、発生する仕組み、文字コードとの関係、困ったときの確認方法を順に解説します。
文字化けの意味と文字コードによる発生の仕組み
それではまず文字化けの意味と発生する仕組みについて解説していきます。
文字データの誤った読み取り
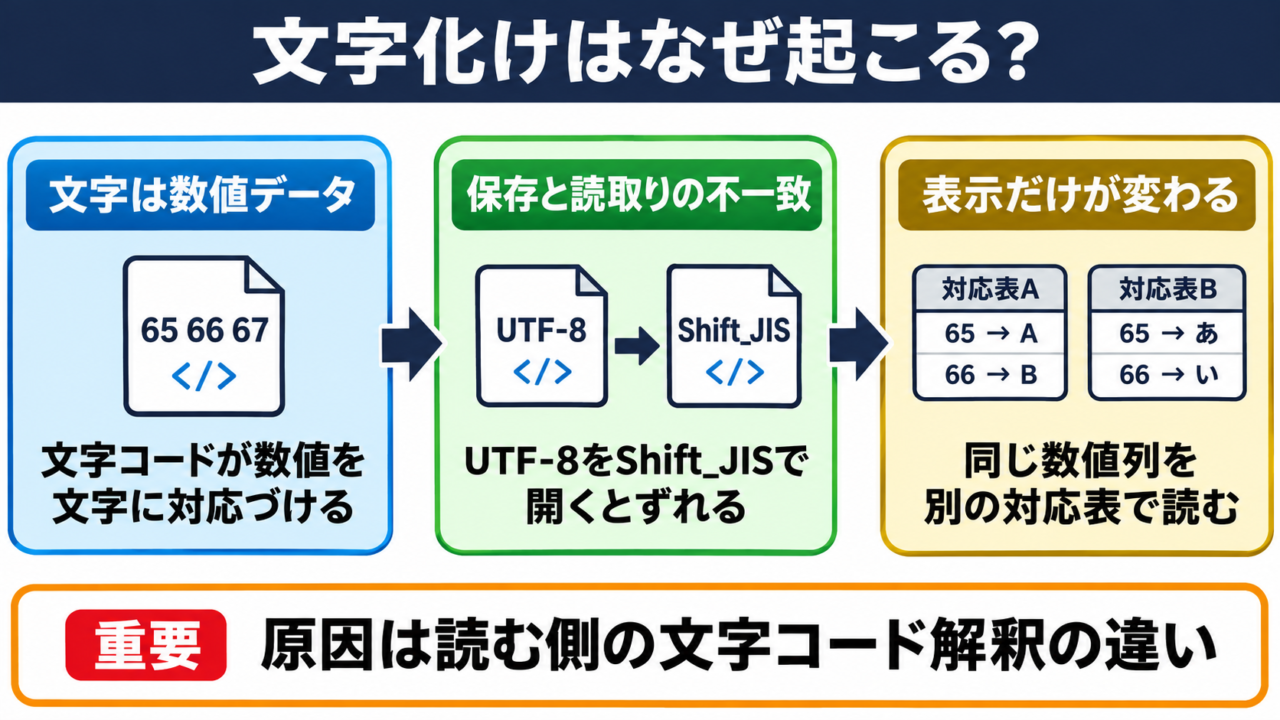
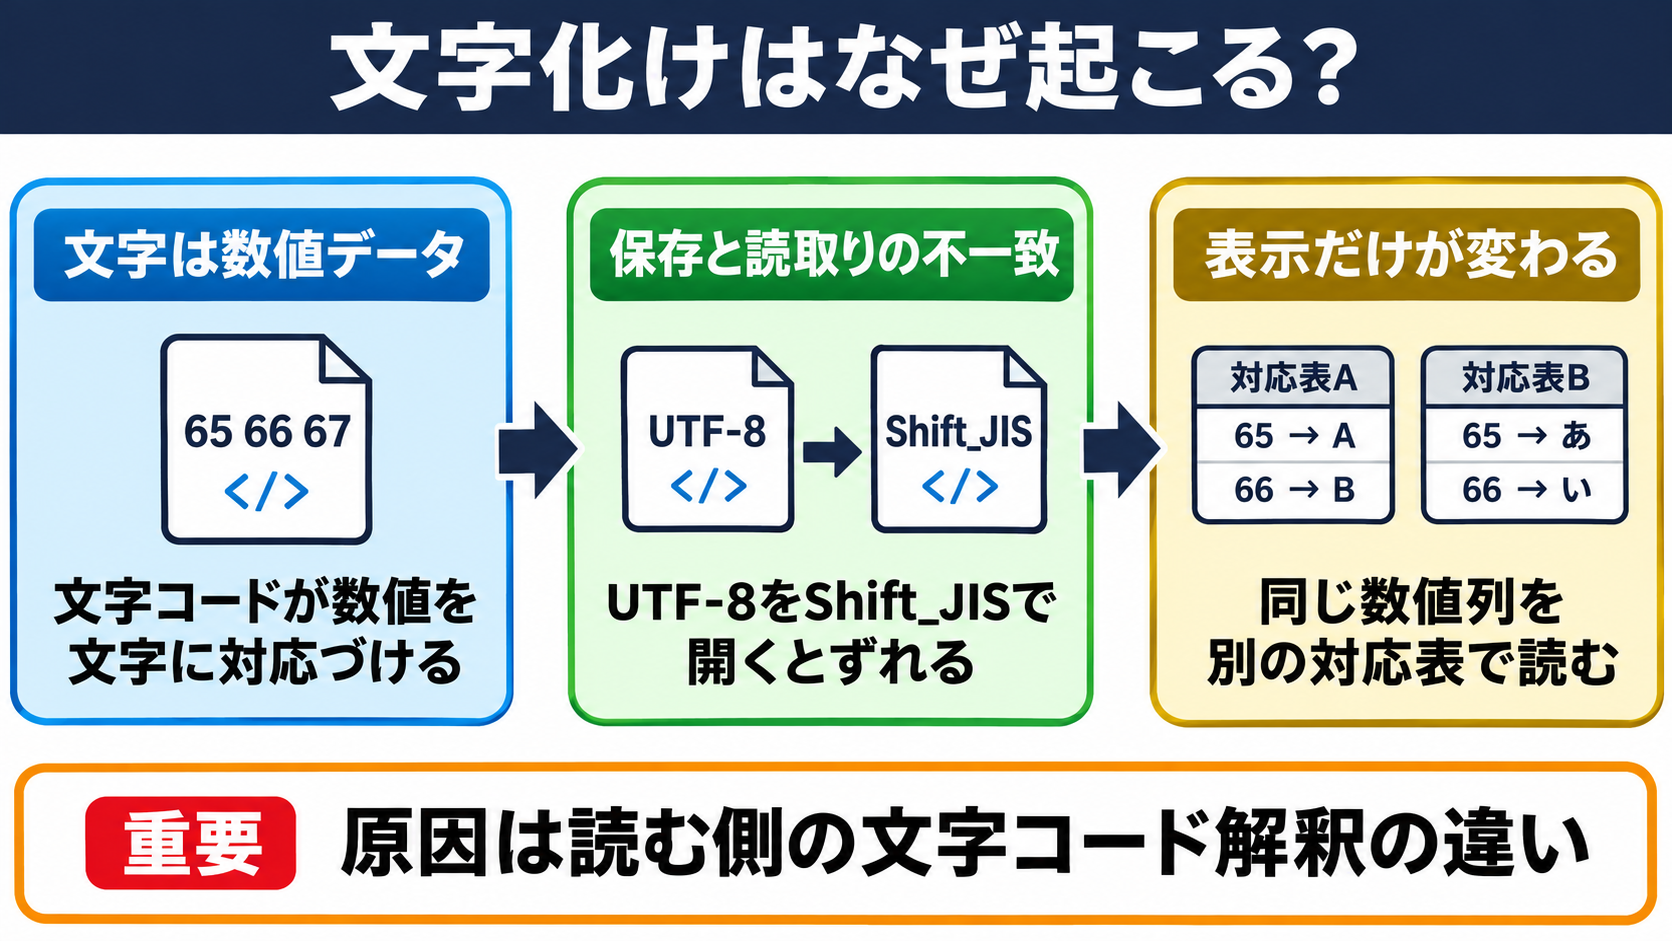
文字化けとは、文字を表すデータを本来とは異なる文字コードで読み取った結果、意図しない文字や記号として表示される現象です。
コンピューターは「あ」や「A」といった文字を、そのまま理解しているわけではありません。
内部では文字ごとに対応する数値を扱い、その数値を文字として表示するためのルールを使っています。
このルールが文字コードであり、送信した側と受信した側で同じルールを使う必要があります。
たとえば、あるデータをUTF-8として保存したのに、受け取ったソフトがShift_JISとして開くと、数値の区切り方や対応する文字が変わります。すると「東京」という文字が意味のない漢字や記号の並びに見える場合があります。
これは文字が勝手に別の言葉へ翻訳された状態ではありません。
同じ数値列を別の対応表で読んだため、表示結果だけが変わった状態です。
日本語は1文字を表すために複数の数値を使う方式が多く、途中から読み取りがずれると、その後の広い範囲まで乱れることがあります。
特にメールの件名やCSVファイルでは、作成した環境と開く環境が異なるため、文字化けが起こりやすいでしょう。
文字化けの中心的な原因は、文字データそのものではなく、データを読む側の文字コードの解釈違いです。
元のファイルを上書きせず、別の文字コードで開き直すことが復旧の基本になります。
文字コードと符号化の役割
文字コードは、文字と数値を対応付けるための規則です。
人が読む文字をコンピューターで保存、送信、表示するには、文字を数値列へ変換する符号化と、数値列を文字へ戻す復号が必要になります。
文字化けは、符号化したときの規則と復号するときの規則が食い違うことで発生します。
たとえば英数字中心の文章であれば、多くの文字コードで共通する部分が多いため、問題に気付きにくいことがあります。
一方、日本語の漢字、ひらがな、カタカナ、丸数字、機種依存文字などを含むと、違いが表面化しやすくなります。
Webページでは、HTMLファイルの保存形式とブラウザへ伝える文字コード情報が一致していることが重要です。ファイルがUTF-8でも、配信時に別の文字コードとして伝われば、ブラウザは誤った規則で解釈する可能性があります。
メールでも本文の文字コードだけでなく、件名、添付ファイル名、送信形式の情報が関係します。
文字コードは文字の見た目を決める書体やフォントとは異なります。
フォントがない場合は四角形の記号などで表示されることがありますが、これは文字化けとは別の問題として考える必要があります。
文字コードの流れ
文字を入力する
↓
文字コードの規則で数値へ変換する
↓
ファイル保存や通信を行う
↓
受信側が同じ規則で数値を文字へ戻す
送信側と受信側の規則が一致すれば、意図した文字として表示されます。
文字化けと表示できない文字の違い
文字化けと似た現象に、文字が豆腐と呼ばれる四角い記号で表示される状態があります。
ただし、四角い記号が出る原因は、使用中のフォントにその文字の字形が用意されていないことである場合も少なくありません。
意味の異なる文字へ置き換わる現象は文字コードの問題、四角形などで表示できない現象はフォント不足の問題であることがあります。
たとえば、古い環境で新しい絵文字や珍しい漢字を開いたとき、正しい文字コードで読めていても、表示用のフォントが対応していなければ四角形になります。
この場合は、別のフォントを選ぶ、OSやアプリを更新する、対応フォントを導入するといった対策が候補になります。
一方で、「ã‚」のように複数の記号や文字へ変わる表示は、UTF-8のデータを別の文字コードとして解釈したときによく見られる形です。
画面上の見た目だけで原因を断定することはできません。
しかし、同じファイルを別のアプリや別の端末で開いて正常に読めるなら、保存内容よりも開き方や環境設定を疑うのが自然です。
文字化けが起こりやすい場面と主な原因
続いては文字化けが起こりやすい場面と主な原因を確認していきます。
CSVファイルと表計算ソフトの読み込み
CSVファイルは表形式のデータを扱いやすく、顧客一覧、商品一覧、集計結果などの受け渡しによく使われます。
しかし、CSVは単純なテキスト形式であり、文字コードの情報が必ずしもファイル内で明確に示されるわけではありません。
CSVの文字化けは、保存時の文字コードと表計算ソフトが自動判定した文字コードの違いで起こりやすい問題です。
作成側がUTF-8で書き出したCSVを、受け取り側がShift_JISとして直接開くと、日本語の列名や氏名が乱れることがあります。
逆に、Windows環境向けとしてShift_JIS系で保存されたCSVを、UTF-8を前提にするサービスへ取り込むと、同様の問題が起こる可能性があります。
文字化けを防ぐには、ファイルをダブルクリックで開く前に、インポート機能を使って文字コードを指定する方法が有効です。区切り文字、引用符、先頭のゼロを残す設定も同時に確認できます。
CSVを編集した後は、保存形式が変わっていないか注意しましょう。
表計算ソフトによっては、保存時に別形式への変換を促す画面が表示され、選択次第で文字コードが変わることがあります。
CSVを受け取ったときの確認手順
元ファイルを複製する
↓
表計算ソフトのインポート機能を選ぶ
↓
UTF-8、Shift_JISなどを切り替えて表示を確認する
↓
正しく読めた設定で取り込む
元ファイルを直接保存し直す前に、必ず複製を残しておきましょう。
メールと添付ファイルの受信環境
メールは送信者、メールサーバー、受信ソフトという複数の環境を通るため、文字化けの要因が増えます。
本文は正常でも件名だけが読めない、添付ファイル名だけが乱れるといったケースもあります。
メールの件名には、文字コードを示す特殊な形式が使われることがあります。
この情報を古いメールソフトや一部の機器が正しく処理できないと、日本語の件名が読めなくなる場合があります。
添付ファイルでは、ファイル名の文字コードに加え、圧縮ソフトの違いやOSの違いも影響します。日本語名のファイルをやり取りするより、英数字のファイル名にしておくと、トラブルを減らせることがあります。
重要な添付ファイルは、ファイル名を英数字中心にし、本文に内容を明記すると確認しやすくなります。
受信者側で文字化けが起きた場合、送信者が同じメールを別形式で再送するだけで解決することもあります。
ただし、業務メールで個人情報や契約情報を送る場合は、単に再送するのではなく、誤送信先がないか、添付内容が適切かも確認することが大切です。
Webサイトとデータベースの設定差
Webサイトの文字化けは、HTML、Webサーバー、データベース、プログラムの複数箇所に文字コード設定があるため、原因を見つけにくい特徴があります。
ページの一部だけが乱れる場合、データベースから取得した文章や外部サービスのデータに原因があるかもしれません。
HTMLでは、文書がどの文字コードで書かれているかをブラウザへ伝える設定が重要です。
一般的にはUTF-8が広く利用されており、新しいWebサイトでは統一して使われることが多くなっています。
しかし、古いデータを移行した場合や、複数のシステムを連携した場合は、データの一部だけが別の文字コードのまま残ることがあります。
その状態で誤った変換を繰り返すと、元の文字列へ戻しにくくなります。
Webサイトでは、HTMLの保存形式、HTTPで送る文字コード情報、データベース接続時の設定をできるだけ同じ文字コードにそろえることが基本です。
特に新規開発や移行時は、UTF-8を基準に統一する設計が管理しやすいでしょう。
代表的な文字コードの特徴と使い分け
続いては代表的な文字コードの特徴と使い分けを確認していきます。
UTF-8とUnicodeの関係
Unicodeは、世界中の多くの文字に共通した番号を割り当てるための国際的な文字集合です。
UTF-8は、そのUnicodeの文字をコンピューター上で数値列として表すための符号化方式の1つになります。
Unicodeが文字の共通番号の考え方であるのに対し、UTF-8はその番号を保存や通信で表現する具体的な方式です。
UTF-8は英数字を比較的効率よく扱え、日本語、中国語、韓国語、絵文字などにも対応しやすいという利点があります。
そのため、Webサイト、プログラミング言語、クラウドサービス、APIなどではUTF-8が標準的に利用される場面が増えています。
ただし、UTF-8であれば必ず文字化けしないわけではありません。
保存時、送信時、受信時のどこかで別の方式として扱われれば、UTF-8のデータでも表示は乱れます。
また、Unicodeに文字があっても、古いOSやフォントが対応していない場合は、正しく表示できないことがあります。
UnicodeとUTF-8を同じ意味として扱わず、文字の番号体系と符号化方式を分けて考えると、問題を整理しやすくなります。
Shift_JISと日本語Windows環境
Shift_JISは、日本語を扱うために長く使われてきた文字コードの一種です。
特に日本語版Windows向けの古いソフトや業務システム、CSVの受け渡しでは、現在でもShift_JIS系の指定を見かけます。
相手先のシステムがShift_JISを指定している場合は、UTF-8で作ったファイルをそのまま渡さず、指定形式に変換する必要があります。
ただし、Shift_JISと呼ばれる形式には、実際には環境ごとの拡張を含む場合があります。
機種依存文字や外字を使うと、同じShift_JIS系の環境でも文字の対応が異なり、別の文字になったり表示できなかったりすることがあります。
たとえば、丸付き数字、特殊な単位記号、旧字体の一部は、受け取り側の環境により扱いが変わる可能性があります。
業務データでは、氏名や住所に含まれる文字を安易に置き換えると、本人確認や帳票作成に支障が出ることもあります。
相手先が指定する文字コード、利用できない文字、改行形式などを事前に確認し、テストデータで取り込み結果を見ることが安全です。
文字コードごとの対応範囲の比較
文字コードには、それぞれ作られた時代や想定する利用環境があります。
現在はUTF-8が幅広く使われますが、既存システムとの連携ではShift_JISやEUC-JPなどに触れることがあります。
| 種類 | 主な特徴 | 使われやすい場面 | 注意点 |
|---|---|---|---|
| UTF-8 | Unicodeを扱える可変長方式 | Webサイト、API、クラウドサービス | 古いソフトでは自動判定を誤る場合がある |
| Shift_JIS | 日本語Windows環境で普及した方式 | 既存業務システム、CSV | 機種依存文字や拡張文字に注意が必要 |
| EUC-JP | Unix系環境で使われてきた日本語方式 | 古いサーバー、既存システム | 新規案件ではUTF-8への統一が多い |
| ISO-2022-JP | メール用途で利用されてきた方式 | 日本語メールの一部 | 特殊な切り替え情報を含む |
表のように、文字コードは優劣だけで選ぶものではありません。
受け渡し先の仕様、既存データ、使用するソフトを踏まえ、全体で同じ方式を使うことが重要です。
文字コードを選ぶ目安
新しいWebサイトやシステム
UTF-8で統一する
取引先指定のCSV
指定された文字コードを優先する
古いシステムとの連携
実データで文字化けと利用可能文字を検証する
文字化けが起きたときの確認方法と予防策
続いては文字化けが起きたときの確認方法と予防策を確認していきます。
元データを守るための確認手順
文字化けを見つけたときに、最初に行いたいのは元ファイルの保護です。
読めない状態のまま編集して保存すると、元に戻せる可能性があったデータまで上書きしてしまうことがあります。
文字化けしたファイルは、まず複製を作成し、複製側で文字コードを変えて開くことが安全です。
テキストエディタの中には、開くときに文字コードを指定できるものがあります。
UTF-8、Shift_JIS、EUC-JPなどを切り替え、どの設定で自然な日本語になるかを確認します。
正常に表示できたら、その表示結果を元に必要な形式へ保存し直します。
ただし、一度誤った文字コードで読み込み、その状態で保存されたファイルは、単純に設定を切り替えるだけで直らない場合があります。
バックアップ、送信前の原本、別の受信者が持つ正常なファイルなどを探すことも重要です。
復旧作業では、文字化けしたファイルを直接上書きしないことが最優先です。
原因を試すたびに別名で保存すれば、失敗しても元の状態へ戻れます。
作成時と共有時に行う予防
文字化けは発生後の修復より、作成時のルール統一で防ぐ方が負担を抑えられます。
チームでファイルを共有する場合は、文字コードだけでなく、ファイル形式、改行、ファイル名の付け方も決めておくとよいでしょう。
Web制作では、編集ソフト、HTMLファイル、データベース、サーバーの設定をUTF-8へそろえる方法が一般的です。
CSVを定期的に連携する業務では、受け渡し仕様書に文字コードを明記し、サンプルファイルで確認する運用が役立ちます。
文字コードを自動判定に任せきりにせず、ファイルの用途ごとに保存形式を決めることが予防につながります。
ファイル名は英数字とハイフン、アンダースコアを中心にすると、メールや圧縮ファイルでの文字化けを避けやすくなります。
ただし、利用者が内容を判断しにくくならないよう、本文や共有メッセージに日本語の説明を添える配慮も必要です。
文字化けの原因と対処法のまとめ
文字化けは、文字を表す数値データを、本来とは異なる文字コードで読み取ることで起こる現象です。
文字コードは、文字を保存、送信、表示するための規則であり、送信側と受信側の設定が一致していることが重要になります。
UTF-8はWebや新しいシステムで広く使われていますが、CSVや既存の業務システムではShift_JISなどが指定されることもあります。
文字化けと、フォント不足による四角い記号の表示は原因が異なるため、見た目だけで同じ問題と決め付けないようにしましょう。
CSVではインポート時の文字コード指定、メールでは件名や添付ファイル名、WebではHTMLとサーバーとデータベースの設定が確認ポイントです。
文字化けしたファイルを見つけたら、まず複製を作り、元データを上書きしない状態で開き方を試してください。
日常的に扱うファイルの文字コードを意識し、共有先の仕様に合わせて保存する習慣を作ると、トラブルを減らしやすくなります。